Valkey, Redis y KeyDB — Bases en Memoria Administradas
Base de Datos como Servicio (DBaaS)Hable con InteSys →Las bases en memoria guardan los datos en RAM y responden en una fracción de milisegundo. Son la capa que quita carga a la base principal: caché de consultas costosas, sesiones de usuario, colas, contadores y límites de solicitudes. Valkey, Redis y KeyDB hablan el mismo protocolo (RESP), así que la aplicación usa las mismas bibliotecas cliente con cualquiera de los tres.
Como parte de Base de Datos como Servicio, InteSys aprovisiona, protege, monitorea y mantiene estas bases en br-sp-1 (Cirion SAO1) y br-sp-2 (Equinix SP3), en Kubernetes o en máquinas virtuales — desde una instancia única hasta topologías con failover automático y réplica en otra región.
Para qué sirven
| Uso | Ejemplo | Recurso del motor |
|---|---|---|
| Caché | Resultados de consultas, páginas renderizadas, respuestas de API | Strings y hashes con TTL, eviction automático |
| Sesiones | Login y carrito compartidos entre varias réplicas de la aplicación | Hashes con expiración |
| Colas y eventos | Jobs en segundo plano, procesamiento asíncrono | Lists y Streams con grupos de consumidores |
| Límite de solicitudes | Rate limiting por usuario, IP o clave de API | INCR atómico con expiración |
| Mensajería ligera | Notificaciones entre servicios | Pub/Sub |
| Rankings y contadores | Marcadores, más vistos, conteos en tiempo real | Sorted sets |
Una base en memoria no reemplaza a la base principal
La replicación es asíncrona y la persistencia en disco tiene una ventana de pérdida. Los datos que no pueden desaparecer — pedidos, pagos, registros de clientes — van en una base transaccional como PostgreSQL o MySQL. La base en memoria guarda lo que se puede recalcular o reprocesar.
¿Valkey, Redis o KeyDB?
| Valkey | Redis | KeyDB | |
|---|---|---|---|
| Licencia | BSD-3, open source | RSALv2/SSPLv1 o AGPLv3 (Redis 8) | BSD-3, open source |
| Mantenedor | Linux Foundation | Redis Ltd. | Snap Inc. |
| Ejecución | Threads de I/O, núcleo de comandos de un solo hilo | Threads de I/O, núcleo de comandos de un solo hilo | Multihilo |
| Replicación | Primario/réplica, Sentinel, Cluster | Primario/réplica, Sentinel, Cluster | También réplica activa y multi-master |
| Cuándo elegirlo | Por defecto para proyectos nuevos y migraciones desde Redis | Dependencia de un módulo o versión específica de Redis | Réplica activa o alto paralelismo en un solo nodo |
En 2024 Redis abandonó la licencia BSD, y la comunidad creó Valkey a partir de la última versión abierta, bajo la Linux Foundation. Valkey mantiene compatibilidad de protocolo y de comandos con Redis, por eso es nuestra recomendación por defecto: misma aplicación, mismas bibliotecas, sin cuestiones de licencia. KeyDB atiende casos específicos, como la réplica activa entre nodos, pero su ritmo de desarrollo es más lento — lo evaluamos con usted antes de adoptarlo.
Topologías
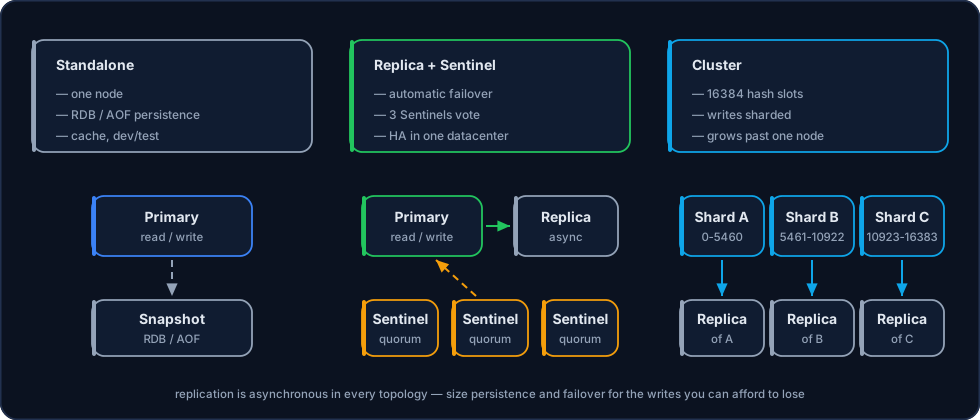
| Topología | Nodos | Failover | Escala de escritura | Indicada para |
|---|---|---|---|---|
| Instancia única | 1 | Reinicio o restauración | Un nodo | Caché descartable, desarrollo, homologación |
| Primario + réplica con Sentinel | 2+ de datos, 3 Sentinels | Automático, en segundos | Un nodo | Sesiones, colas y caché de producción |
| Cluster | 3+ primarios, cada uno con réplica | Automático, por shard | Distribuida en hash slots | Datos o tráfico mayores que un nodo |
| Réplica activa (KeyDB) | 2+ nodos con escritura | Sin promoción: todos aceptan escrituras | Todos los nodos | Casos específicos, con conflictos aceptables |
- Instancia única — un nodo, con o sin persistencia. Si cae, vuelve por reinicio o desde el último snapshot; la aplicación debe tolerar unos instantes sin caché.
- Primario + réplica con Sentinel — Sentinel vigila al primario y, cuando la mayoría (quórum) de los tres coincide en que cayó, promueve la réplica e informa la nueva dirección a los clientes. Es la topología de producción más común.
- Cluster — los datos se dividen en 16.384 hash slots entre varios primarios, cada uno con su réplica y failover propio, sin Sentinel. Los comandos que involucran varias claves exigen que estén en el mismo slot (hash tags, como
{pedido:42}). - Réplica activa — en KeyDB, los nodos aceptan escrituras al mismo tiempo y se replican entre sí. Las escrituras concurrentes sobre la misma clave se resuelven por la última escritura, por lo que solo sirve a cargas que lo toleran.
Replicación asíncrona: el failover puede perder las últimas escrituras
El primario confirma la escritura antes de que la réplica la reciba. Si cae en ese intervalo, la réplica promovida no tiene esas escrituras. Para operaciones críticas, el comando WAIT reduce la ventana al esperar la confirmación de las réplicas — pero no la convierte en replicación síncrona.
Persistencia
| Modo | Pérdida posible en una caída | Costo | Uso típico |
|---|---|---|---|
| Sin persistencia | Todo el contenido | Ninguno | Caché pura, que se reconstruye desde la base principal |
| RDB (snapshot) | Todo desde el último snapshot (minutos) | Fork periódico, picos de memoria | Caché que conviene mantener caliente, backups |
AOF everysec | Cerca de 1 segundo de escrituras | Escritura continua en disco | Sesiones, colas y contadores |
AOF always | Prácticamente ninguna | Latencia alta en cada escritura | Raramente; prefiera una base transaccional |
En producción, el estándar es AOF everysec con snapshots RDB para backup: la recuperación usa el AOF, y los RDB se copian a almacenamiento fuera del servidor con la misma política de retención que los demás backups.
Memoria y dimensionamiento
En una base en memoria, la RAM es el límite del conjunto de datos. Dimensionamos tres cosas:
maxmemoryy política de eviction — el límite que impide que el proceso agote la memoria del servidor, y qué hacer al alcanzarlo.- Holgura para el fork — los snapshots RDB y la reescritura del AOF usan copy-on-write; con muchas escrituras, la memoria puede crecer bastante por encima del conjunto de datos durante el fork. Por eso reservamos una holgura generosa cuando hay persistencia.
- Fragmentación — seguida con la métrica
mem_fragmentation_ratio, con desfragmentación activa cuando hace falta.
| Política | Comportamiento al alcanzar el límite | Indicada para |
|---|---|---|
allkeys-lfu / allkeys-lru | Elimina las claves menos usadas | Caché |
volatile-lru / volatile-ttl | Elimina solo claves con expiración | Caché y datos permanentes en la misma base |
noeviction | Rechaza nuevas escrituras | Sesiones y colas, donde perder datos en silencio es peor que un error |
Caché y colas en instancias separadas
La caché quiere eviction; las colas y sesiones no pueden perder datos. En la misma base, cualquier política perjudica al otro uso. Separar las instancias también aísla el impacto de un pico de caché sobre las colas.
Multirregión
- Réplica en otra región — una réplica asíncrona en br-sp-2 sirve de recuperación ante desastres para el primario en br-sp-1, y de lectura local para aplicaciones en ambos centros de datos.
- Caché regional — cada región mantiene su propia caché, alimentada por la base principal local o por réplicas de lectura. Nada se replica entre cachés, y la latencia entre regiones sale del camino de las lecturas. Vea el patrón en PostgreSQL Multirregión.
- Réplica activa entre regiones — posible con KeyDB, pero con resolución de conflictos por última escritura. Indicada solo después de evaluar el modelo de datos.
Seguridad
- Red privada — la base nunca se expone a internet; acceso solo desde la red de la aplicación, con políticas de red en Kubernetes o firewall en las VMs.
- TLS — cifrado entre aplicación y base, y entre nodos cuando la arquitectura atraviesa redes.
- ACLs — un usuario por aplicación, con solo los comandos y prefijos de clave necesarios. Comandos peligrosos como
FLUSHALL,CONFIGyKEYSquedan fuera de los permisos de la aplicación. - Sin contraseña compartida — cada aplicación tiene su propia credencial, revocable sin afectar a las demás.
Operación y monitoreo
| Métrica | Qué indica | Alerta cuando |
|---|---|---|
used_memory vs. maxmemory | Cercanía al límite | Por encima del 80% sin eviction configurado |
evicted_keys | Caché demasiado pequeña | Crecimiento continuo |
Hit ratio (keyspace_hits / misses) | Eficiencia de la caché | Caída respecto a la línea base |
| Retraso de replicación | Réplica atrasada respecto al primario | Por encima del límite acordado |
mem_fragmentation_ratio | Memoria desperdiciada | Por encima de 1,5 por un período prolongado |
| Slowlog y latencia | Comandos que bloquean el núcleo | Comandos por encima de unos milisegundos |
Las actualizaciones de versión se hacen réplica por réplica, con failover controlado para actualizar el primario. Cada alerta tiene runbook, como en las demás bases del DBaaS.
Niveles de servicio
| Nivel | Topología | Indicado para |
|---|---|---|
| Instancia única | Un nodo, con o sin persistencia | Caché descartable, desarrollo y homologación |
| Alta disponibilidad | Primario + réplica con Sentinel, o Cluster | Sesiones, colas y caché de producción |
| Multirregión | Réplica en br-sp-2, o cachés regionales | Recuperación ante desastres y lectura local en ambos centros de datos |
Punto de partida recomendado
Valkey con primario, una réplica y tres Sentinels, AOF everysec y snapshots RDB fuera del servidor. Cubre las fallas reales de un solo centro de datos sin la complejidad del Cluster. Solicite una propuesta para dimensionar su carga.
Preguntas frecuentes
Mi aplicación usa Redis. ¿Funciona con Valkey?
En la gran mayoría de los casos, sí: Valkey mantiene el protocolo y los comandos de Redis, y las bibliotecas cliente son las mismas. La excepción son los módulos y recursos exclusivos de versiones recientes de Redis — en esos casos, operamos el propio Redis.
¿Puedo usar Valkey o Redis como base principal?
Para datos que se pueden recalcular o reprocesar, sí. Para datos que no pueden perderse, no: la replicación es asíncrona e incluso el AOF tiene ventana de pérdida. El patrón estándar es la base en memoria delante de una base transaccional.
¿Cuánta memoria necesito?
El tamaño del conjunto de datos más holgura para fork, fragmentación y crecimiento. Medimos el conjunto real (o lo estimamos a partir de la base principal) en el dimensionamiento, antes de aprovisionar.
¿Kubernetes o máquina virtual?
Ambos funcionan. En Kubernetes, un operador gestiona réplicas y failover cerca de la aplicación. En VMs, el aislamiento de memoria es más predecible para conjuntos de datos grandes. Lo definimos con usted según la carga.
Próximos Pasos
- Base de Datos como Servicio (DBaaS) — Niveles de servicio, motores y contratación
- PostgreSQL Multirregión — Caché regional con Valkey delante de una base remota
- Alta Disponibilidad PostgreSQL — La base transaccional detrás de la caché
- Backup y Restauración — Retención y restauración probada
- Kubernetes como Servicio (KaaS) — Bases en memoria cerca de la aplicación
- Hablar con un especialista — Converse sobre la arquitectura de su caché