Valkey, Redis e KeyDB — Bancos em Memória Gerenciados
Banco de Dados como Serviço (DBaaS)Fale com a InteSys →Bancos em memória guardam os dados na RAM e respondem em fração de milissegundo. São a camada que tira carga do banco principal: cache de consultas caras, sessões de usuário, filas, contadores e limites de requisição. Valkey, Redis e KeyDB falam o mesmo protocolo (RESP), então a aplicação usa as mesmas bibliotecas cliente com qualquer um dos três.
Como parte do Banco de Dados como Serviço, a InteSys provisiona, protege, monitora e mantém esses bancos em br-sp-1 (Cirion SAO1) e br-sp-2 (Equinix SP3), em Kubernetes ou em máquinas virtuais — de uma instância única até topologias com failover automático e réplica em outra região.
Para que servem
| Uso | Exemplo | Recurso do motor |
|---|---|---|
| Cache | Resultado de consultas, páginas renderizadas, respostas de API | Strings e hashes com TTL, eviction automático |
| Sessões | Login e carrinho compartilhados entre várias réplicas da aplicação | Hashes com expiração |
| Filas e eventos | Jobs em segundo plano, processamento assíncrono | Lists e Streams com grupos de consumidores |
| Limite de requisições | Rate limiting por usuário, IP ou chave de API | INCR atômico com expiração |
| Mensageria leve | Notificações entre serviços | Pub/Sub |
| Rankings e contadores | Placar, mais vistos, contagem em tempo real | Sorted sets |
Banco em memória não substitui o banco principal
A replicação é assíncrona e a persistência em disco tem janela de perda. Dados que não podem sumir — pedidos, pagamentos, cadastro — ficam em um banco transacional como PostgreSQL ou MySQL. O banco em memória guarda o que pode ser recalculado ou reprocessado.
Valkey, Redis ou KeyDB?
| Valkey | Redis | KeyDB | |
|---|---|---|---|
| Licença | BSD-3, open source | RSALv2/SSPLv1 ou AGPLv3 (Redis 8) | BSD-3, open source |
| Mantenedor | Linux Foundation | Redis Ltd. | Snap Inc. |
| Execução | Threads de I/O, núcleo de comandos single-thread | Threads de I/O, núcleo de comandos single-thread | Multithread |
| Replicação | Primário/réplica, Sentinel, Cluster | Primário/réplica, Sentinel, Cluster | Também réplica ativa e multi-master |
| Quando escolher | Padrão para projetos novos e migrações de Redis | Dependência de módulo ou versão específica do Redis | Réplica ativa ou alto paralelismo em um único nó |
Em 2024 o Redis deixou a licença BSD, e a comunidade criou o Valkey a partir da última versão aberta, sob a Linux Foundation. O Valkey mantém compatibilidade de protocolo e de comandos com o Redis, por isso é a nossa recomendação padrão: mesma aplicação, mesmas bibliotecas, sem questão de licença. O KeyDB atende casos específicos, como réplica ativa entre nós, mas tem ritmo de desenvolvimento mais lento — avaliamos com você antes de adotá-lo.
Topologias
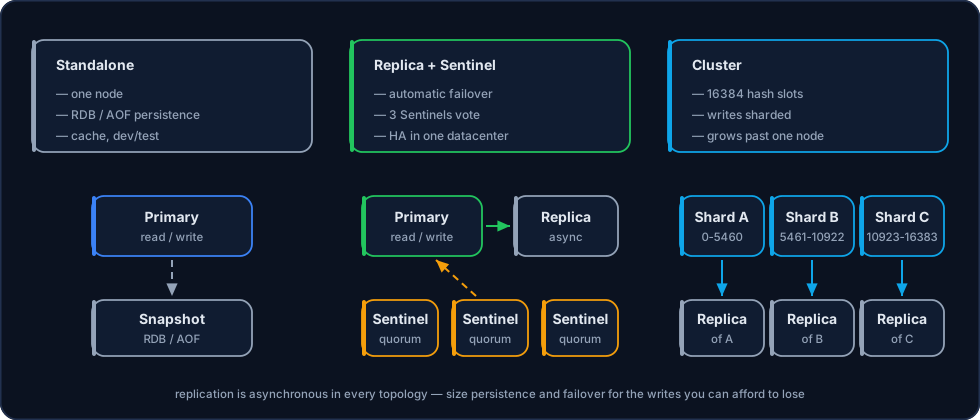
| Topologia | Nós | Failover | Escala de escrita | Indicada para |
|---|---|---|---|---|
| Instância única | 1 | Reinício ou restauração | Um nó | Cache descartável, desenvolvimento, homologação |
| Primário + réplica com Sentinel | 2+ dados, 3 Sentinels | Automático, em segundos | Um nó | Sessões, filas e cache de produção |
| Cluster | 3+ primários, cada um com réplica | Automático, por shard | Distribuída em hash slots | Dados ou tráfego maiores que um nó |
| Réplica ativa (KeyDB) | 2+ nós graváveis | Sem promoção: todos aceitam escrita | Todos os nós | Casos específicos, com conflitos aceitáveis |
- Instância única — um nó, com ou sem persistência. Se cair, volta pelo reinício ou pelo último snapshot; a aplicação precisa tolerar alguns instantes sem cache.
- Primário + réplica com Sentinel — o Sentinel monitora o primário e, quando a maioria (quórum) dos três concorda que ele caiu, promove a réplica e informa o novo endereço aos clientes. É a topologia de produção mais comum.
- Cluster — os dados são divididos em 16.384 hash slots entre vários primários, cada um com sua réplica e failover próprio, sem Sentinel. Comandos que envolvem várias chaves exigem que elas estejam no mesmo slot (hash tags, como
{pedido:42}). - Réplica ativa — no KeyDB, os nós aceitam escrita ao mesmo tempo e se replicam entre si. Escritas concorrentes na mesma chave resolvem pela última escrita, então serve apenas a cargas que toleram isso.
Replicação assíncrona: o failover pode perder as últimas escritas
O primário confirma a escrita antes de a réplica recebê-la. Se ele cair nesse intervalo, a réplica promovida não tem essas escritas. Para operações críticas, o comando WAIT reduz a janela ao esperar a confirmação das réplicas — mas não a transforma em replicação síncrona.
Persistência
| Modo | Perda possível em uma queda | Custo | Uso típico |
|---|---|---|---|
| Sem persistência | Todo o conteúdo | Nenhum | Cache puro, que se reconstrói a partir do banco principal |
| RDB (snapshot) | Tudo desde o último snapshot (minutos) | Fork periódico, picos de memória | Cache que vale manter aquecido, backups |
AOF everysec | Cerca de 1 segundo de escritas | Escrita contínua em disco | Sessões, filas e contadores |
AOF always | Praticamente nenhuma | Latência alta em toda escrita | Raramente; prefira um banco transacional |
Em produção, o padrão é AOF everysec com snapshots RDB para backup: a recuperação usa o AOF, e os RDB são copiados para armazenamento fora do servidor com a mesma política de retenção dos demais backups.
Memória e dimensionamento
Em um banco em memória, a RAM é o limite do conjunto de dados. Dimensionamos três coisas:
maxmemorye política de eviction — o limite que impede o processo de esgotar a memória do servidor e o que fazer ao atingi-lo.- Folga para o fork — snapshots RDB e reescrita do AOF usam copy-on-write; com muitas escritas, a memória pode crescer bem acima do conjunto de dados durante o fork. Por isso reservamos folga generosa quando há persistência.
- Fragmentação — acompanhada pela métrica
mem_fragmentation_ratio, com desfragmentação ativa quando necessário.
| Política | Comportamento ao atingir o limite | Indicada para |
|---|---|---|
allkeys-lfu / allkeys-lru | Remove as chaves menos usadas | Cache |
volatile-lru / volatile-ttl | Remove só chaves com expiração | Cache e dados permanentes no mesmo banco |
noeviction | Recusa novas escritas | Sessões e filas, onde perder dado em silêncio é pior que um erro |
Cache e fila em instâncias separadas
Cache quer eviction; fila e sessão não podem perder dado. No mesmo banco, uma política sempre prejudica o outro uso. Separar as instâncias também isola o impacto de um pico de cache sobre as filas.
Multi-região
- Réplica em outra região — uma réplica assíncrona em br-sp-2 serve de recuperação de desastres para o primário em br-sp-1, e de leitura local para aplicações nos dois datacenters.
- Cache regional — cada região mantém o próprio cache, alimentado pelo banco principal local ou por réplicas de leitura. Nada é replicado entre caches, e a latência entre regiões sai do caminho das leituras. Veja o padrão em PostgreSQL Multi-Região.
- Réplica ativa entre regiões — possível com KeyDB, mas com resolução de conflito por última escrita. Indicada só depois de avaliar o modelo de dados.
Segurança
- Rede privada — o banco nunca é exposto à internet; acesso só pela rede da aplicação, com políticas de rede no Kubernetes ou firewall nas VMs.
- TLS — criptografia entre aplicação e banco e entre nós, quando a arquitetura atravessa redes.
- ACLs — usuários por aplicação, com só os comandos e prefixos de chave necessários. Comandos perigosos como
FLUSHALL,CONFIGeKEYSficam fora das permissões da aplicação. - Sem senha compartilhada — cada aplicação tem a própria credencial, revogável sem afetar as outras.
Operação e monitoramento
| Métrica | O que indica | Alerta quando |
|---|---|---|
used_memory vs. maxmemory | Proximidade do limite | Acima de 80% sem eviction configurado |
evicted_keys | Cache pequeno demais | Crescimento contínuo |
Hit ratio (keyspace_hits / misses) | Eficiência do cache | Queda em relação à linha de base |
| Atraso de replicação | Réplica atrás do primário | Acima do limite acordado |
mem_fragmentation_ratio | Memória desperdiçada | Acima de 1,5 por período prolongado |
| Slowlog e latência | Comandos bloqueando o núcleo | Comandos acima de alguns milissegundos |
Atualizações de versão são feitas réplica por réplica, com failover controlado para atualizar o primário. Cada alerta tem runbook, como nos demais bancos do DBaaS.
Níveis de serviço
| Nível | Topologia | Indicado para |
|---|---|---|
| Instância única | Um nó, com ou sem persistência | Cache descartável, desenvolvimento e homologação |
| Alta disponibilidade | Primário + réplica com Sentinel, ou Cluster | Sessões, filas e cache de produção |
| Multi-região | Réplica em br-sp-2, ou caches regionais | Recuperação de desastres e leitura local nos dois datacenters |
Ponto de partida recomendado
Valkey com primário, uma réplica e três Sentinels, AOF everysec e snapshots RDB fora do servidor. Cobre as falhas reais de um único datacenter sem a complexidade do Cluster. Solicite uma proposta para dimensionar a sua carga.
Perguntas frequentes
Minha aplicação usa Redis. Ela funciona com Valkey?
Na grande maioria dos casos, sim: o Valkey mantém o protocolo e os comandos do Redis, e as bibliotecas cliente são as mesmas. A exceção são módulos e recursos exclusivos de versões recentes do Redis — nesses casos, operamos o próprio Redis.
Posso usar Valkey ou Redis como banco principal?
Para dados que podem ser recalculados ou reprocessados, sim. Para dados que não podem ser perdidos, não: a replicação é assíncrona e mesmo o AOF tem janela de perda. O padrão é o banco em memória na frente de um banco transacional.
Quanta memória eu preciso?
O tamanho do conjunto de dados mais folga para fork, fragmentação e crescimento. Medimos o conjunto real (ou estimamos a partir do banco principal) no dimensionamento, antes de provisionar.
Kubernetes ou máquina virtual?
Os dois funcionam. Em Kubernetes, um operador cuida das réplicas e do failover, perto da aplicação. Em VMs, o isolamento de memória é mais previsível para conjuntos de dados grandes. Definimos com você conforme a carga.
Próximos Passos
- Banco de Dados como Serviço (DBaaS) — Níveis de serviço, motores e contratação
- PostgreSQL Multi-Região — Cache regional com Valkey na frente de um banco remoto
- Alta Disponibilidade PostgreSQL — O banco transacional por trás do cache
- Backup e Restauração — Retenção e restauração testada
- Kubernetes como Serviço (KaaS) — Bancos em memória perto da aplicação
- Fale com um especialista — Discuta a arquitetura do seu cache